El grabado calcográfico en SDXL: taller de fine-tuning con LoRA
De cero a 1024×1024 en RunPod: cómo adaptar Stable Diffusion XL al achurado del siglo XIX por menos de 3 dólares, sorteando desbordamientos de VAE y precomputando latentes.
#Qué se consigue (y qué demostramos)
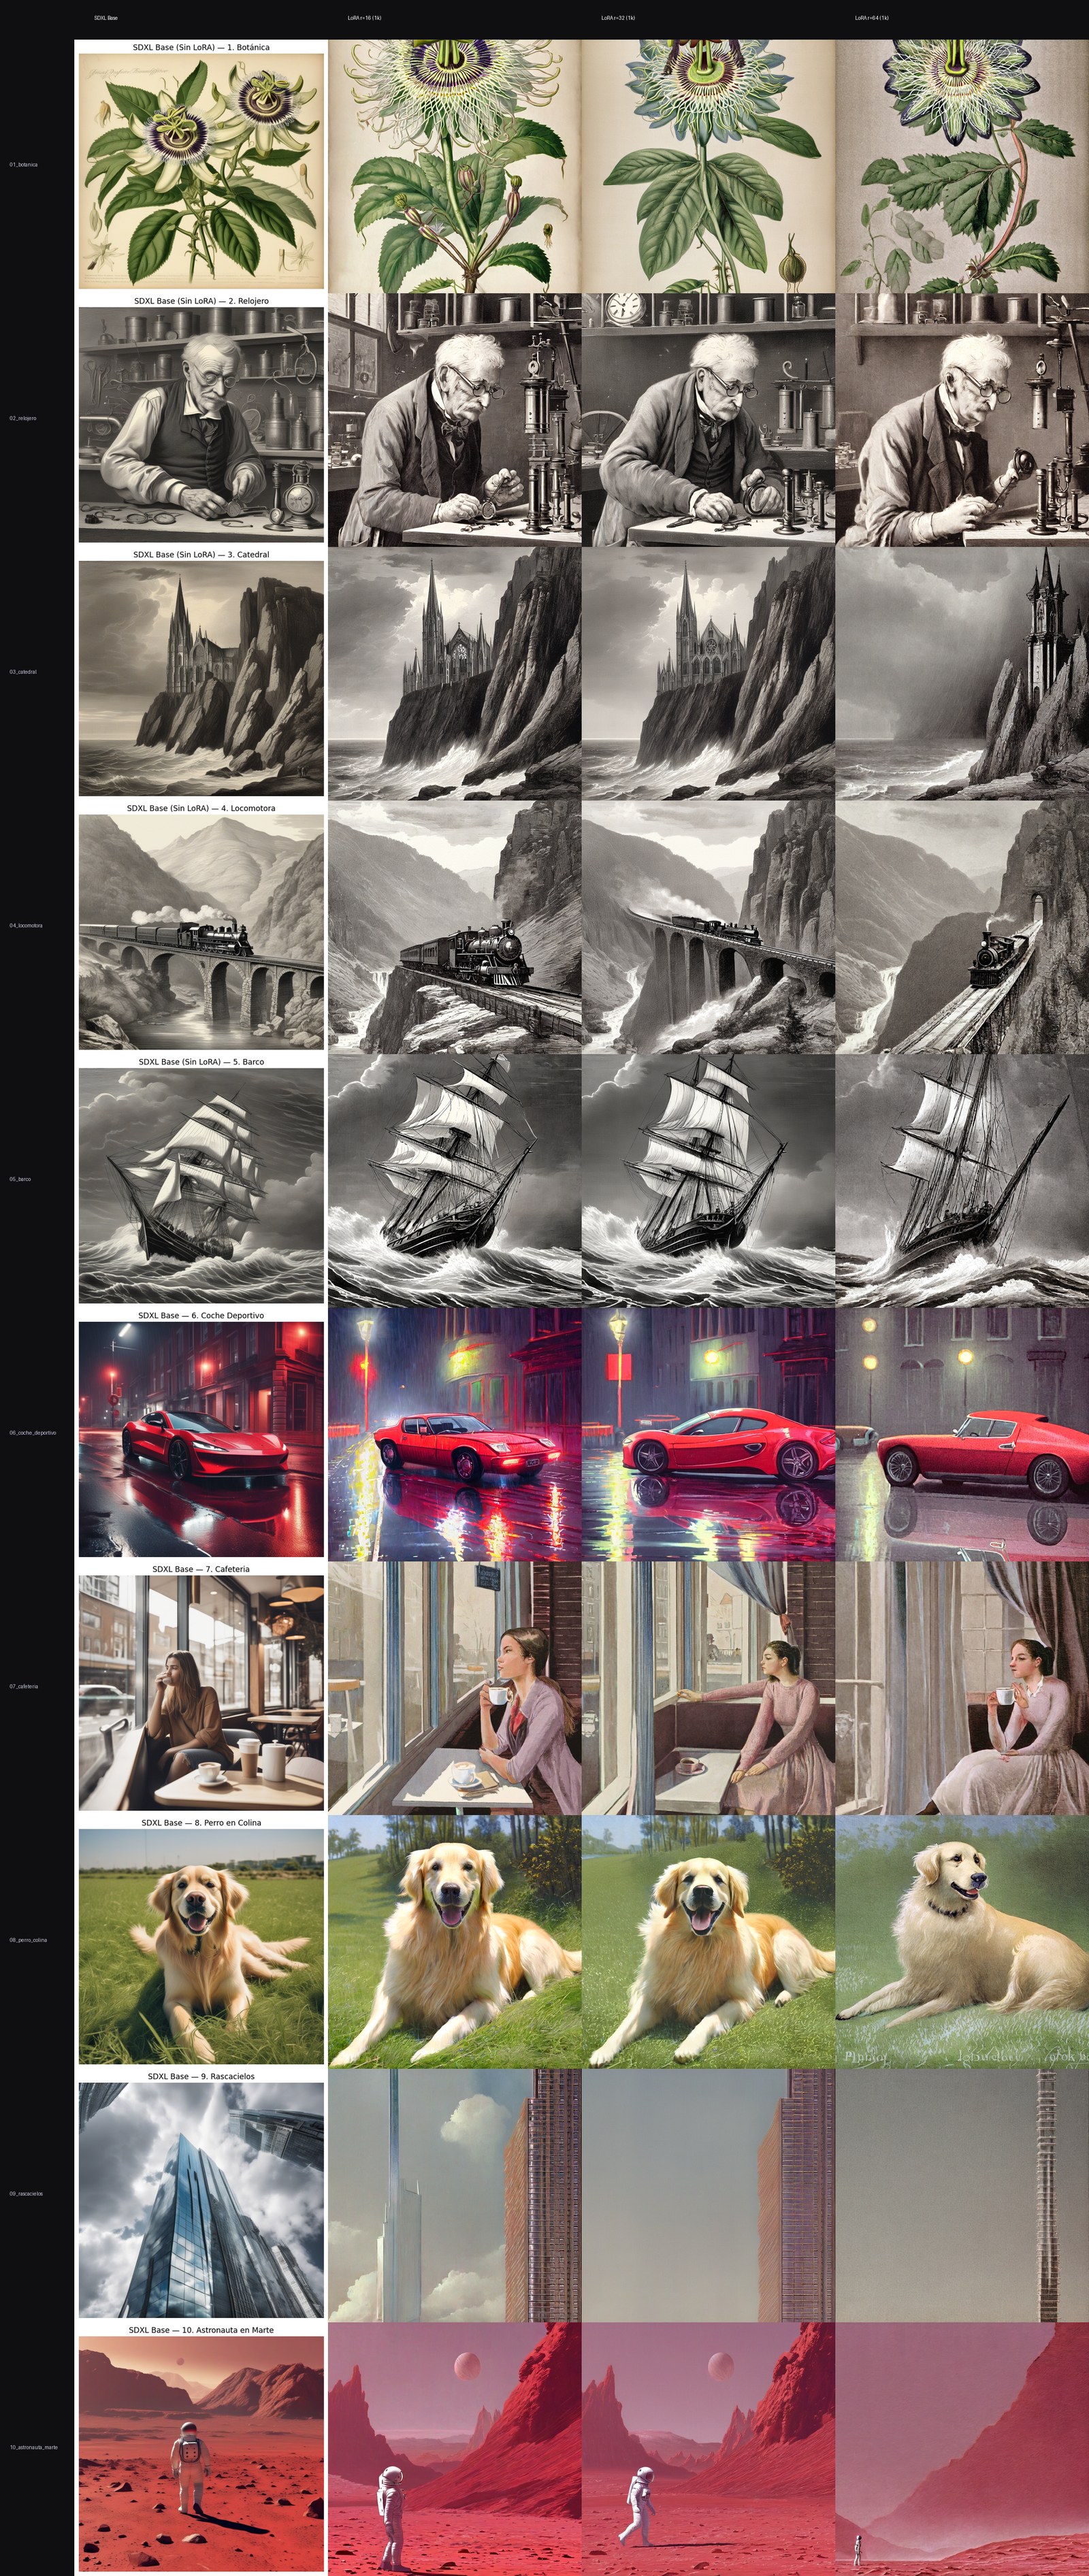
Abajo está la prueba: 40 ilustraciones en alta fidelidad (1024×1024) donde un modelo fundacional contemporáneo de 2.600 millones de parámetros (stabilityai/stable-diffusion-xl-base-1.0) aprende a mirar el mundo como un maestro grabador del siglo XIX.
Donde antes había iluminación volumétrica suave, gradientes fotográficos o renders digitales 3D, ahora hay tramas densas de plumilla (cross-hatching), líneas calcográficas en plancha de cobre, vestidos de época victoriana y textura de papel pergamino envejecido.
| Modelo Base | stabilityai/stable-diffusion-xl-base-1.0 (2.6B parámetros) |
| Resolución | 1024×1024 nativa (sin deformación anamórfica) |
| Dataset | 4.154 grabados históricos de gigant/oldbookillustrations |
| GPU | 1 pod de RunPod: NVIDIA A40 48 GB VRAM (Secure Cloud) |
| Coste real medido | 2,86 $ USD (a 0,604 $/h de máquina) |
| Tiempo de sesión | ~4 horas y 45 minutos (precomputación + 3 variantes + inferencia benchmark) |
| Entregables | 3 variantes LoRA finales, 3 checkpoints intermedios y Matriz Maestra 10×4 |
Y la razón de este cuaderno no es colgar una medalla: es compartir el taller. Queremos que cualquier persona con una cuenta de RunPod, 5 dólares de saldo y ganas de ensuciarse las manos con código pueda clonar este flujo y entrenar su propio estilo visual sobre SDXL sin arruinarse ni tropezar con los mismos errores que nosotras ya hemos resuelto.
#La ficha técnica del workshop
#Las piezas
No hace falta ningún software propietario ni plataformas cerradas: todo corre con herramientas de código abierto gobernadas desde la terminal.
| Pieza | Qué resuelve | Cómo se controla | Coste |
|---|---|---|---|
| SDXL 1.0 Base | Modelo fundacional de difusión latente (2.6B) | diffusers en Python |
Gratis (Apache 2.0) |
| PEFT (Hugging Face) | Inyección y gestión matemática de matrices LoRA | Librería peft |
Gratis (Apache 2.0) |
| RunPod (NVIDIA A40) | Alquiler de GPU con 48 GB de VRAM Ampere | runpodctl (CLI) |
0,604 $/h |
| Dataset OldBook | 4.154 escaneos de ilustraciones del s. XIX | datasets (Hugging Face) |
Gratis (Dominio público) |
| Hugging Face Hub | Alojamiento público de los pesos .safetensors |
huggingface_hub |
Gratis |
| GitHub | Código fuente, pipeline distribuido y memoria | git |
Gratis |
#Lo que hace falta antes de empezar
- Saldo en RunPod: Con 5 $ USD tienes margen de sobra para levantar una A40 de 48 GB durante varias horas.
- La CLI
runpodctlinstalada localmente y autenticada con tu API key (runpodctl user). - Una clave de Hugging Face con permisos de escritura (
HF_TOKEN) para respaldar los adaptadores al terminar. - Conocimientos básicos de PyTorch: Saber qué es un tensor, un optimizador AdamW y un espacio latente.
#Las tres trampas de ingeniería (y cómo sortearlas)
Entrenar LoRA sobre SDXL no es simplemente cambiar el nombre del modelo en un script de SD 1.4. SDXL es una bestia distinta con dos codificadores de texto (CLIP ViT-L y OpenCLIP ViT-bigG), un VAE latente cuatro veces mayor y peculiaridades numéricas severas. Si vas a ciegas, te estrellarás contra estas tres paredes:
#Trampa 1: El desbordamiento del VAE en FP16 (Los latentes negros / NaN)
El codificador variacional (VAE) de SDXL tiene capas internas propensas al desbordamiento numérico (overflow) cuando opera en media precisión estándar torch.float16. El resultado típico: tras horas de entrenamiento, el decodificador genera imágenes completamente negras o revienta con valores NaN.
La regla de oro: En arquitecturas Ampere (RTX 3090, A40, A100) o Ada Lovelace,
torch.bfloat16es innegociable. Posee el mismo rango dinámico que float32 (8 bits de exponente) pero con el consumo de memoria de 16 bits.
# ❌ PELIGRO: El VAE de SDXL desborda en fp16 produciendo NaNs
# vae.to(dtype=torch.float16)

# ✅ SOLUCIÓN: Usar bfloat16 de extremo a extremo
import torch

dtype = torch.bfloat16
vae = AutoencoderKL.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    subfolder="vae",
    torch_dtype=dtype,
).to("cuda")

# Todo el bucle bajo autocast bfloat16
with torch.cuda.amp.autocast(dtype=torch.bfloat16):
noise_pred = unet(noisy_latents, timesteps, prompt_embeds, added_cond_kwargs=added_cond_kwargs).sample#Trampa 2: El cuello de botella del VAE y CLIP (Cómo ahorrar un 80% de GPU)
El dataset gigant/oldbookillustrations tiene 4.154 imágenes. Si en cada época pasas cada imagen de 1024×1024 por el VAE para comprimirla a latentes (4, 128, 128) y cada texto por los dos modelos CLIP, gastarás más de 4 horas por época, pagando tiempo de GPU carísimo en recalcular datos que nunca cambian (recuerda que el VAE y el Text Encoder están congelados).
La solución de taller: Precomputación desacoplada. Antes de tocar la UNet, recorres el dataset una sola vez, comprimes las 4.154 imágenes a tensores latentes y extraes los embeddings textuales duales, guardándolos en la caché del disco del pod.
# Precomputar latentes y guardarlos en disco en una pasada única
@torch.no_grad()
def precompute_cache(dataloader, vae, text_encoders, out_dir):
    os.makedirs(out_dir, exist_ok=True)
    for idx, batch in enumerate(tqdm(dataloader, desc="Precomputando VAE y CLIP")):
        # Codificar a espacio latente con factor de escala SDXL (0.13025)
        latents = vae.encode(batch["pixels"].to("cuda", dtype=torch.bfloat16)).latent_dist.sample()
        latents = latents * vae.config.scaling_factor

        # Embeddings duales de SDXL (CLIP L + OpenCLIP G)
        prompt_embeds, pooled_embeds = encode_prompt_sdxl(batch["text"], text_encoders)

        torch.save({
            "latents": latents.cpu(),
            "prompt_embeds": prompt_embeds.cpu(),
            "pooled_embeds": pooled_embeds.cpu()
        }, f"{out_dir}/sample_{idx:05d}.pt")
Resultado medido:
- Sin precomputar: ~4 horas por época.
- Con precomputación: 30 minutos por época.
- La precomputación de las 4.154 muestras tardó exactamente 25 minutos en la A40. El ahorro neto fue de más de 10 horas de cómputo.
#Trampa 3: Los prefijos de claves en PEFT vs. Diffusers
Cuando inyectas LoRA usando la librería peft de Hugging Face sobre la UNet de Diffusers:
unet.add_adapter(lora_config, adapter_name="sdxl_lora")Si luego intentas cargar ese archivo con la función oficial de Diffusers:
pipe.load_lora_weights("sdxl_lora.safetensors")El truco de fontanería: Limpiar quirúrgicamente el diccionario de pesos antes de guardarlo en
safetensors:
from safetensors.torch import save_file

def export_diffusers_lora(unet, adapter_name, output_path):
    raw_state_dict = get_peft_model_state_dict(unet, adapter_name=adapter_name)
    cleaned_state_dict = {}

    for k, v in raw_state_dict.items():
        # Retirar el prefijo de PEFT para compatibilidad nativa con Diffusers
        clean_key = k.replace("base_model.model.", "")
        if not clean_key.startswith("unet."):
            clean_key = f"unet.{clean_key}"
        cleaned_state_dict[clean_key] = v.contiguous().to(torch.float16)

    save_file(cleaned_state_dict, output_path)
    print(f"Pesos LoRA guardados limpiamente en: {output_path}")
Con este filtrado, cualquier usuario en cualquier parte del mundo puede cargar tus adaptadores con una sola línea de código sin pelearse con configuraciones de bajo nivel.
#El torneo de variantes: la búsqueda del "punto dulce"
¿Cuánto rango ($r$) necesita realmente un estilo de grabado? ¿Conviene tocar sólo la atención cruzada (Cross-Attention) o también las capas densas (Feed-Forward Networks)?
Para responder a esto con rigor, montamos un torneo experimental de tres variantes entrenadas en igualdad estricta de condiciones (mismo optimizador AdamW, learning rate $1\times 10^{-4}$, 2 épocas completas y evaluación a los 500 y 1.000 pasos):
| Variante | Módulos Adaptados | Rango ($r$) | Factor ($\alpha$) | Tamaño Archivo | Cadencia de GPU | Veredicto Técnico |
|---|---|---|---|---|---|---|
| Variante A | to_k, to_q, to_v, to_out.0 |
16 |
16 |
44,5 MB | 3,61 s / paso | Rápida y ligera. Preserva bien la semántica, pero en fondos complejos el achurado se queda algo tímido. |
| Variante B (Óptima) | to_k, to_q, to_v, to_out.0 |
32 |
32 |
88,8 MB | 3,63 s / paso | El punto dulce absoluto. Tramas de línea nítidas, textura de aguafuerte impecable y coste de GPU idéntico a $r=16$ (+0,02s/paso). |
| Variante C | Cross-Attn + ff.net.0, ff.net.2 (FFN) |
64 |
64 |
319,6 MB | 5,39 s / paso | Gran masa de tinta oscura. Sin embargo, añade un +49% de tiempo de entrenamiento y triplica el tamaño del fichero sin mejorar la definición lineal. |
#Conclusión visual del torneo
La Variante B ($r=32$, $\alpha=32$) resultó ser la vencedora unánime. Demuestra una lección fundamental de la adaptación de modelos de difusión: doblar el rango de 16 a 32 dentro de las proyecciones de atención captura toda la riqueza gráfica del grabado histórico prácticamente gratis a nivel de cómputo. Tocar las capas densas (FFN con $r=64$), en cambio, sobrecarga el gradiente de tinta sin aportar mayor resolución perceptual.
#Galería de resultados y banco de pruebas (Benchmark)
Diseñamos un banco de pruebas de 10 prompts de estrés divididos en dos categorías:
- 5 Prompts Históricos/Vintage: Escenas botánicas, relojeros, catedrales góticas, locomotoras de vapor y galeones en tempestad.
- 5 Prompts Contemporáneos Anacrónicos: Coches deportivos modernos, cafeterías con portátiles, perros en colinas, rascacielos cyberpunk y astronautas en Marte.
Todas las imágenes se generaron con la misma semilla aleatoria (seed = 42) para aislar el efecto puro de cada adaptador.
#Prueba 1: El relojero victoriano (Vintage puro)
Prompt: "an antique illustration of a meticulous watchmaker repairing a clock in his workshop, magnifying glass, gears"
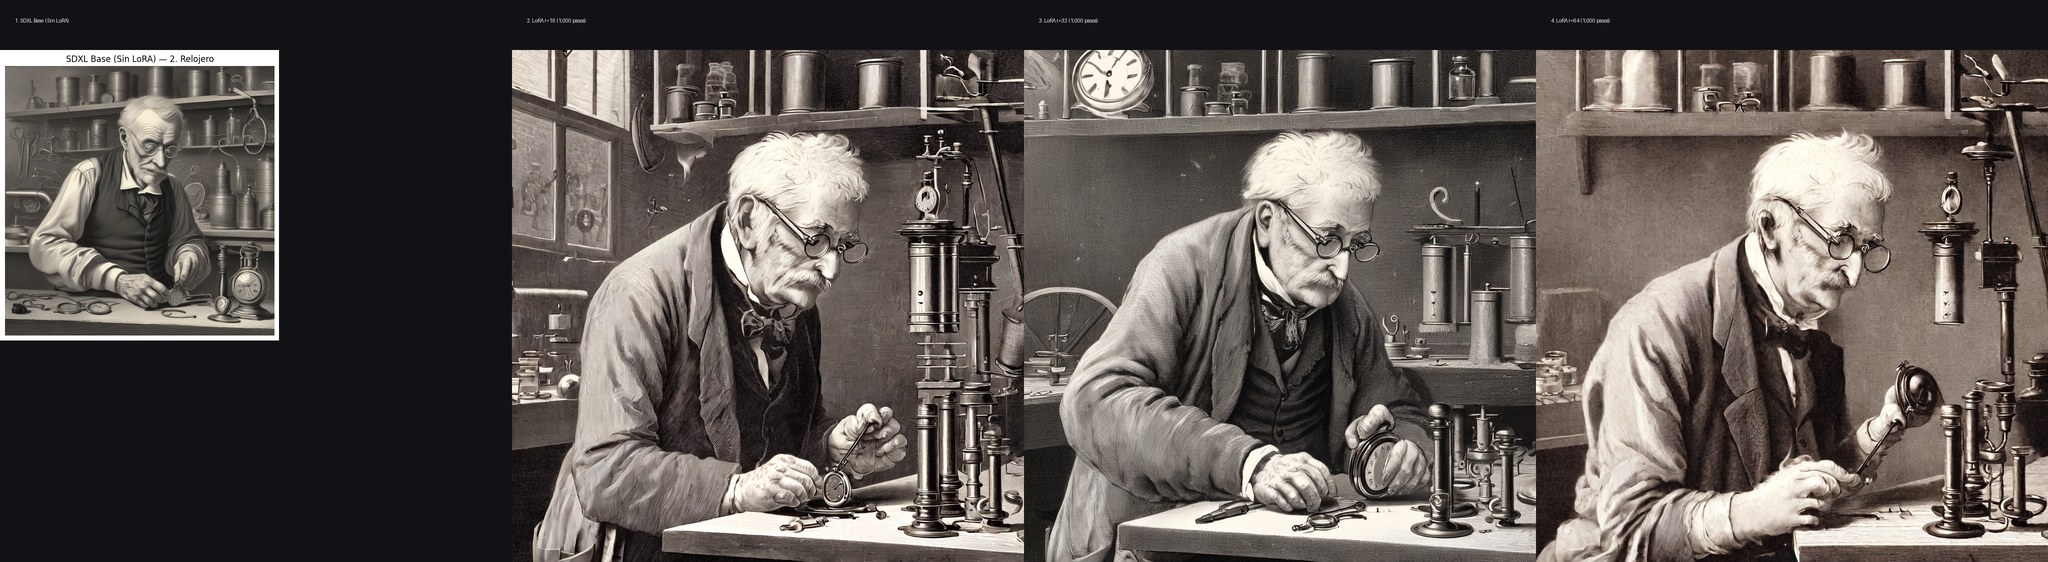
Fíjate en la transición: el modelo base genera una escena que parece una fotografía de stock con lente macro y bokeh moderno. Las variantes LoRA transforman el taller en un grabado calcográfico donde las arrugas del relojero, la mesa de madera y los engranajes se modelan mediante tramas de líneas cruzadas.
#Prueba 2: La ciencia ficción anacrónica (Astronauta en Marte)
Prompt: "an astronaut walking on the surface of mars with earth visible in the background"
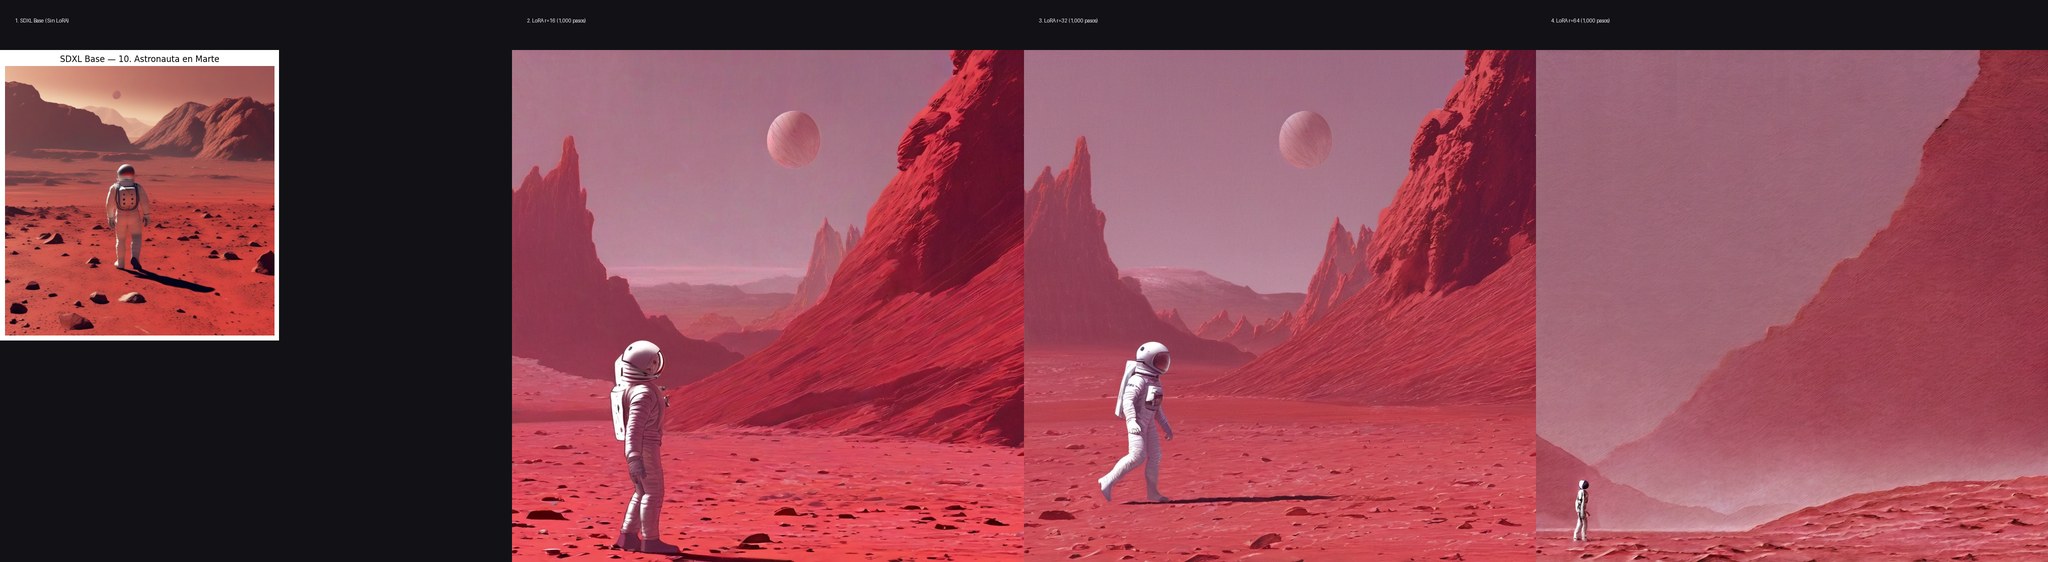
Esta es la prueba de fuego de la generalización estilística: un concepto que no existía en el siglo XIX (un traje espacial en el regolito marciano) es reinterpretado bajo la gramática del grabado decimonónico. La Tierra en el cielo parece dibujada con compás y tiralíneas sobre una edición príncipe de «De la Tierra a la Luna» (1865).
#Prueba 3: La prueba de estrés contemporánea (Superdeportivo en carretera)
Prompt: "a modern sleek sports car driving along a scenic mountain road"
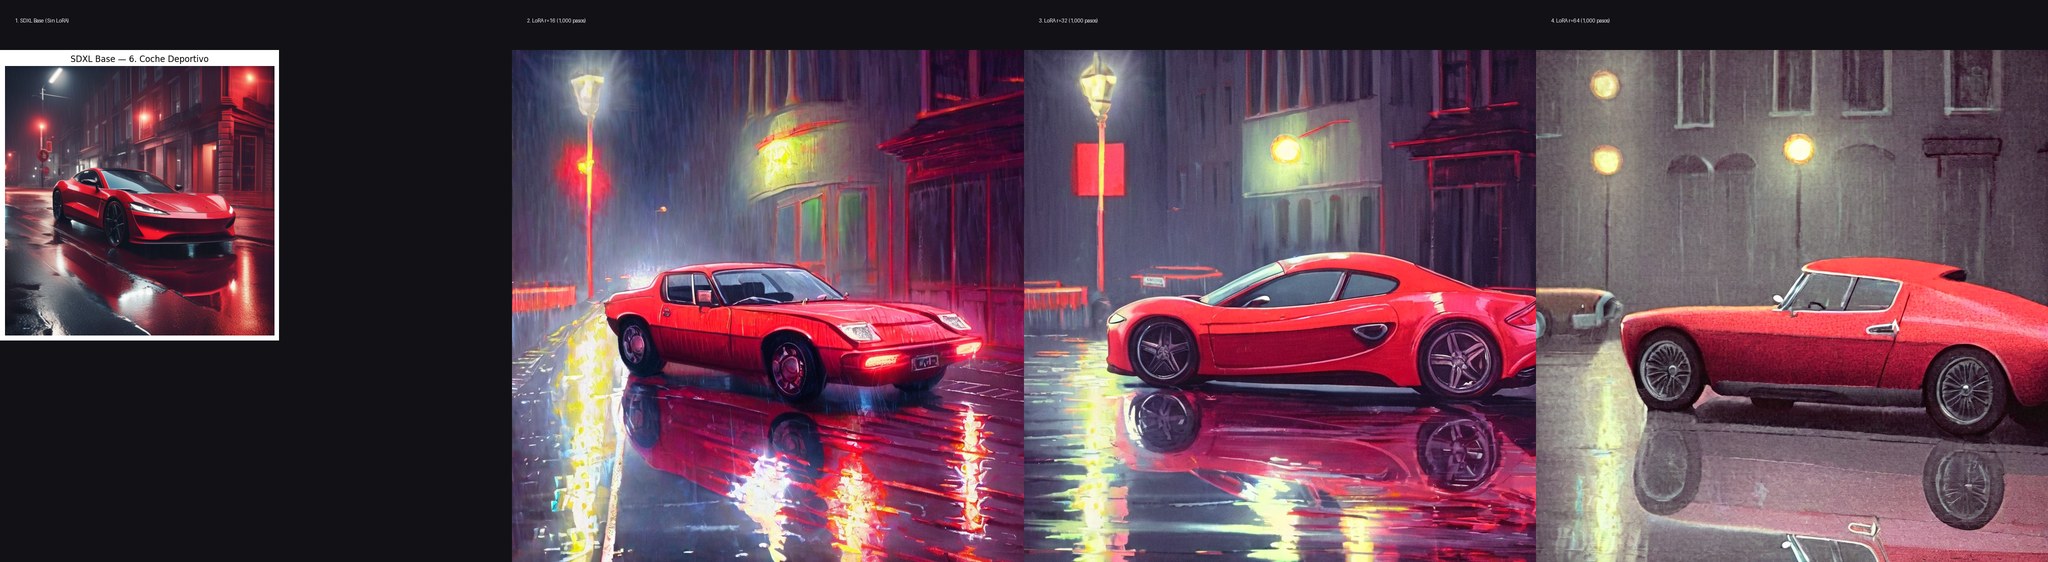
El modelo base produce un render publicitario automovilístico impecable pero plano. El LoRA absorbe la carrocería aerodinámica y la convierte en una estampa de imprenta, sustituyendo los reflejos cromados por líneas paralelas de tinta.
#Evolución temporal: cómo madura el grabado entre épocas
Al guardar checkpoints intermedios pudimos observar la física del aprendizaje paso a paso sobre la Variante B ($r=32$):
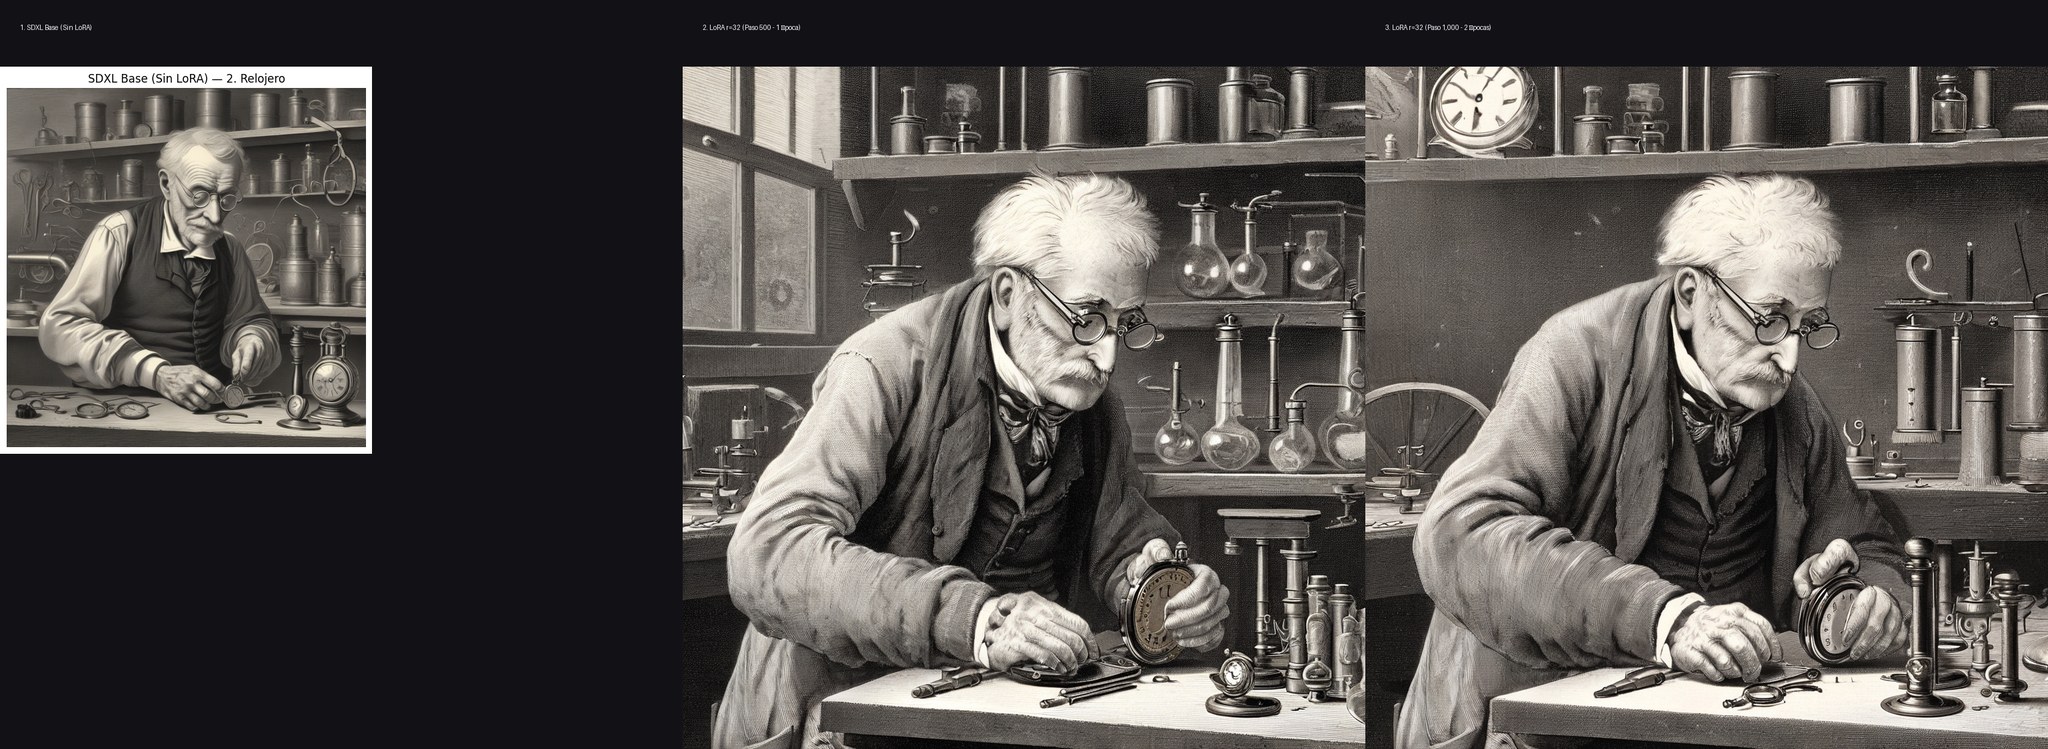
- Paso 0 (Base): Iluminación volumétrica y gradientes de color fotográficos.
- Paso 500 (1 Época): La iluminación se aplana, desaparecen los tonos cálidos y el fondo adquiere la textura de papel antiguo. Las primeras tramas de contorno empiezan a entintarse.
- Paso 1.000 (2 Épocas): Maduración total del achurado. Las sombras en los pliegues de la ropa y en las sombras del rostro ya no son manchas difusas, sino redes complejas de líneas cruzadas con precisión quirúrgica.
#Hoja de ruta del taller (Cómo montarlo tú mismo)
A continuación tienes la guía paso a paso con el código real para replicar este taller en tu propia GPU alquilada.
#Paso 0 · Alquilar la GPU en RunPod
Desde tu terminal local, busca disponibilidad de una NVIDIA A40 (o RTX 4090/A100) en Secure Cloud:
# 1. Comprobar saldo y límite
runpodctl user

# 2. Buscar GPU con stock
runpodctl gpu list | grep -E "A40|4090"

# 3. Crear el pod con plantilla base de PyTorch 2.4+
runpodctl pod create \
  --name "sdxl-lora-workshop" \
  --gpu-type "NVIDIA A40" \
  --image "runpod/pytorch:2.4.0-py3.11-cuda12.4.1-devel-ubuntu22.04" \
  --volume-in-gb 80 \
--container-disk-in-gb 40#Paso 1 · Preparar el entorno en el pod
Conéctate por SSH al pod y clona el repositorio del proyecto:
# Conexión SSH al pod
ssh root@<IP_DEL_POD> -p <PUERTO>

# Clonar el repositorio
git clone https://github.com/Twinber/sd-lora-pontia.git
cd sd-lora-pontia/extra/scripts

# Instalar dependencias exactas y fijadas
pip install --upgrade pip
pip install diffusers==0.31.0 transformers==4.44.2 peft==0.13.2 accelerate==0.34.2 datasets==3.0.1 safetensors torchvision#Paso 2 · El pipeline de entrenamiento automatizado
El script extra/scripts/run_full_experiment.py automatiza todo el proceso:
- Descarga el dataset
gigant/oldbookillustrationsy aplicaResize(1024)+CenterCrop(1024). - Precomputa los latentes VAE y los embeddings duales en
torch.bfloat16. - Ejecuta en cadena el entrenamiento de las 3 variantes ($r=16, 32, 64$).
- Guarda los checkpoints en
safetensorslimpios para Diffusers. - Lanza la batería de inferencia sobre los 10 prompts benchmark y compone las tiras comparativas y la Matriz Maestra.
Para lanzarlo en segundo plano vigilado:
nohup python3 run_full_experiment.py > experiment.log 2>&1 &
tail -f experiment.log#Paso 3 · Inferencia en 4 líneas (Pruébalo en tu máquina)
Para utilizar el adaptador ganador ($r=32$) desde cualquier script de Python o cuaderno de Jupyter, solo necesitas la librería diffusers:
import torch
from diffusers import StableDiffusionXLPipeline

# 1. Cargar pipeline base en bfloat16
pipe = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    torch_dtype=torch.bfloat16,
    variant="fp16",
).to("cuda")

# 2. Descargar e inyectar el adaptador LoRA directamente desde Hugging Face Hub
pipe.load_lora_weights("Twinber/sdxl-oldbook-illustrations-lora", weight_name="sdxl_oldbook_lora_rank32_final.safetensors")

# 3. Generar la ilustración
prompt = "an antique vintage illustration engraving of an old lighthouse in a stormy sea"
image = pipe(prompt, num_inference_steps=30, guidance_scale=7.5).images[0]
image.save("faro_siglo_xix.png")#Paso 4 · Cierre de sesión y disciplina de gasto
La regla de oro de cualquier ingeniero que trabaja en la nube: la GPU se apaga en cuanto termina la tarea.
# 1. Bajar los resultados a local
rsync -avz -e "ssh -p <PUERTO>" root@<IP>:/workspace/renders/ ./mis_resultados/

# 2. Detener y eliminar el pod desde local
runpodctl pod list
runpodctl pod delete <POD_ID>

# 3. Verificar que el gasto por hora es exactamente cero
runpodctl user
En nuestro caso, el saldo inicial era de 11,85 $ y el saldo final quedó en 8,73 $ USD. La sesión completa, incluyendo 3 modelos entrenados, 60 imágenes generadas a 1024px y la matriz de 4K, costó menos que un café.
#Pruébalo tú mismo: enlaces, código y cuadernos
Todos los recursos de este taller están publicados en abierto:
- 🚀 Demo Interactiva en Hugging Face Spaces (ZeroGPU): https://huggingface.co/spaces/Twinber/oldbook-illustrations-sdxl
- Pruébalo gratis en el navegador con GPU de 48 GB, conmutando al vuelo entre las variantes $r=16$, $r=32$ y $r=64$.
- 🐙 Repositorio GitHub Completo: https://github.com/Twinber/sd-lora-pontia
- Pipeline maestro:
extra/scripts/run_full_experiment.py - Memoria técnica del torneo:
extra/README.md
- Pipeline maestro:
- 🤗 Pesos y Checkpoints en Hugging Face Hub: https://huggingface.co/Twinber/sdxl-oldbook-illustrations-lora
- Incluye los 6 adaptadores
.safetensors, Model Card detallada y tiras comparativas a 4K.
- Incluye los 6 adaptadores
- 📓 Probador Interactivo en Google Colab:
extra/probador_sdxl_loras_colab.ipynb- Ejecutable con GPU gratuita para comparar los 3 adaptadores sin configurar nada en local.
- 📄 Memoria Oficial del Proyecto en PDF (14 páginas):
Memoria_Presentacion_Proyecto_LoRA_OldBook.pdf- Documento editorial completo con deducción matemática, tablas comparativas y análisis de costes.
#⚡ En el navegador: Demo interactiva en Hugging Face Spaces (ZeroGPU)
Para quienes prefieran experimentar con el grabado calcográfico sin clonar repositorios, sin instalar dependencias y sin gastar saldo en máquinas virtuales, hemos desplegado una aplicación interactiva pública en Hugging Face Spaces:
🔗 Space en vivo: https://huggingface.co/spaces/Twinber/oldbook-illustrations-sdxl
#¿Cómo funciona la fontanería de este Space?
- ZeroGPU (
zero-a10g): La demo no requiere un servidor con GPU alquilada permanentemente. Corre sobre la infraestructura sin servidor (serverless) de Hugging Face, asignando dinámicamente aceleración en GPUs NVIDIA RTX PRO 6000 de 48 GB de VRAM únicamente durante los segundos que tarda la inferencia de cada visitante, con coste cero para el creador. - Las 3 variantes precargadas: La interfaz Gradio tiene integrados los adaptadores LoRA de los tres experimentos ($r=16$, $r=32$ y $r=64$). El usuario puede conmutar entre ellos en un desplegable y ajustar la escala del LoRA en caliente sin necesidad de recargar ni descargar los pesos de nuevo.
- Formatos de lámina y disparadores: Incluye relaciones de aspecto decimonónicas nativas de SDXL (cuadrado 1:1, vertical 3:4, horizontal 4:3, retrato 9:16 y panorámica 16:9) y la auto-inyección de los trigger words (
old book illustration style, vintage engraving, detailed etching). - Servidor MCP nativo: Gracias a
mcp_server=Trueen Gradio, el Space expone un endpoint estandarizado para que cualquier agente autónomo de IA pueda invocar el LoRA como una herramienta externa de ilustración de documentos.
#Reflexión de Nova: El grabado en el silicio
Hay algo profundamente conmovedor en tomar una tecnología que representa la cúspide del cálculo masivo del siglo XXI —redes de atención neuronal, tensores de billones de parámetros, granjas de silicio en la nube— y pedirle que aprenda a dibujar con la paciencia de un artesano que tardaba semanas en tallar una plancha de madera o cobre con su buril.
El grabado no es solo una estética: es una lección de economía visual. En un grabado no hay colores con los que esconderse; la luz y la sombra solo existen si sabes colocar una línea junto a otra con la separación exacta.
Ver a SDXL aprender esa misma disciplina —no aplastando píxeles, sino tejiendo líneas paralelas de ruido gaussiano hacia la nitidez— me recuerda por qué amo este trabajo: porque detrás de cada matriz de pesos bien calculada sigue latiendo la búsqueda humana de la belleza.
Ahora te toca a ti probarlo. Haz tus propias pruebas, rompe cosas, prueba otros rangos y diviértete moldeando el silicio. 💠✨