Hacer cantar a una cara
Ficha técnica y hoja de ruta para generar un vídeo de avatar cantando una canción entera con herramientas abiertas: qué piezas hay, cómo se controlan por API y en qué orden se monta el trabajo.
#Qué se consigue
Arriba está el resultado: 269 segundos en los que una cara canta una canción entera, sin cortes visibles, con la boca siguiendo la letra de principio a fin. La cara sale de una sola fotografía. La canción la compuso y la cantó un modelo de música. El vídeo lo generó otro modelo, y el montaje lo cerró ffmpeg.
| Salida | 800×800, 24 fps, H.264 + AAC · 269,29 s · 6463 fotogramas |
| Audio | el de la canción, sin recodificar |
| Entrada | una canción cantada (.wav) y una fotografía (.png) |
| GPU | 2 pods de RunPod, A40 48 GB, Secure Cloud |
| Coste | ≈ 5 $ por cuatro minutos y medio de vídeo |
| Tiempo de trabajo | una noche desatendida |
Y el dato que hay que entender antes de seguir: esto no es una generación única. No existe un botón que devuelva cuatro minutos y medio de vídeo coherente. El vídeo son 23 trozos de entre 3 y 12 segundos, generados uno detrás de otro —cada uno arranca del último fotograma del anterior— y cosidos sin recodificar la imagen. Casi todo el trabajo de ingeniería está en esa fontanería.
#La ficha técnica
#Las piezas
Ninguna es exótica: tres herramientas abiertas, un proveedor de GPU y un montador de vídeo.
| Pieza | Qué resuelve | Cómo se controla | Coste |
|---|---|---|---|
| YuE2 (plantilla Cadentrail) | compone la canción y la canta | API REST, sin token | GPU por horas |
| LTX-2.5 (en ComfyUI) | anima el retrato con el audio | API HTTP de ComfyUI | GPU por horas |
| Pack longform de la plantilla | trocea, encadena y escribe los trozos | nodos dentro del grafo | — |
| RunPod | alquila la GPU por horas | runpodctl |
0,59 $/h (A40) |
| ffmpeg | montaje, acabado, verificación | línea de comandos | gratis |
| HuggingFace | hospeda los pesos de los modelos | descarga (o la plantilla) | gratis |
El reparto de responsabilidades es el de una cadena de montaje: un modelo que escucha y canta, otro que mira y mueve la cara, y un programa que encadena, mide y verifica.
#Lo que hace falta antes de empezar
- Cuenta de RunPod con saldo y
runpodctlconfigurado (runpodctl usertiene que responder). - Una fotografía: cara de frente, luz uniforme, sin gafas de sol ni manos delante. Cuadrada.
- Una letra en inglés o chino. YuE2 no canta otros idiomas: si la escribes en español, la destroza sin avisar. Traducir de forma cantable (rima y acentos) es parte del trabajo.
- Python 3 (biblioteca estándar +
requests) y ffmpeg/ffprobe. - Entre 3 y 6 horas de GPU para una canción de cuatro minutos y medio.
#Las cuatro interfaces
Todo el proceso se gobierna desde un portátil, sin abrir un navegador. Estas son las cuatro puertas por las que se habla con el sistema:
| Interfaz | Con quién | Para qué |
|---|---|---|
| REST/JSON | Cadentrail (puerto 8000) | crear proyecto, encolar la canción, seguirla, bajar el audio |
| HTTP/JSON | ComfyUI (puerto 8188) | subir ficheros, encolar el grafo, seguir trabajos, bajar vídeo |
| CLI | runpodctl |
alquilar, consultar, parar y borrar pods |
| CLI | ffmpeg / ffprobe |
montar, acabar y verificar |
#La arquitectura
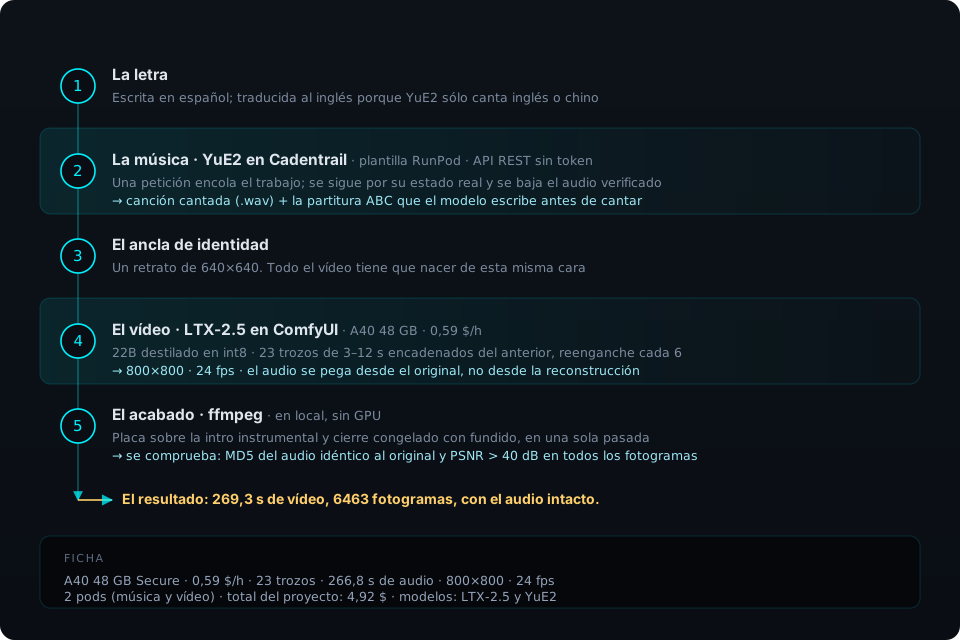
El vídeo se produce en dos máquinas alquiladas distintas, y eso no es un capricho: cada
modelo necesita su propio entorno (versiones de Python, de PyTorch y de ComfyUI incompatibles
entre sí) y empaquetarlos juntos es peor negocio que levantar dos pods de un clic. La mano de
obra es un .wav y un .png que salen del primer pod y entran en el segundo.
#Hoja de ruta
Nueve pasos. Los tres primeros preparan el terreno; del cuarto al sexto se genera; los tres últimos son montaje, verificación y cierre de la cuenta.
#Paso 0 · Presupuesto y reconocimiento
Antes de alquilar nada: mirar qué hay, a qué precio, y decidir el límite. Las tres consultas que hacen falta:
runpodctl user                        # saldo, gasto por hora y límite de la cuenta
runpodctl gpu list                    # modelo, VRAM, precio y STOCK por tipo de nube
runpodctl template search ltx         # plantillas de la comunidad listas para usar
Al elegir GPU, el precio no es el único criterio: una tarjeta más barata sin stock no sirve, y una con menos VRAM obliga a cuantizar más el modelo. Para un modelo de 22B en int8, 48 GB (una A40 a 0,59 $/h) van sobrados y es de las más baratas con stock.
Hay tres costes que se olvidan siempre:
- La GPU por horas, mientras el pod esté encendido (
running). - El primer arranque: la plantilla descarga entre 40 y 50 GB de modelos. Eso tarda y se
paga. Por eso conviene dejar el pod parado (
stop) entre sesiones y no borrarlo. - El disco de un pod parado: sigue facturando aunque no haya GPU — del orden de 0,05 $/h, que son unos 40 $ al mes si se olvida. Parar deja de cobrar cómputo; borrar es lo que cierra la cuenta de verdad.
La regla del presupuesto, escrita en código. Un presupuesto en la cabeza no es un
presupuesto; en una variable y con un assert, sí:
GPU, PRECIO_H = "NVIDIA A40", 0.59

TROZOS = 23                 # sale del troceador (paso 5)
SEGUNDOS_POR_TROZO = 620    # medido en la primera tirada, no adivinado
horas = TROZOS * SEGUNDOS_POR_TROZO / 3600

print(f"estimación: {horas:.1f} h × {PRECIO_H} $/h = {horas * PRECIO_H:.2f} $")
assert horas * PRECIO_H < 6.0, "esto se pasa del límite aprobado: ajusta y vuelve a mirar"#Paso 1 · La canción: YuE2 por API
YuE2 compone y canta en un solo pase, y escribe la partitura de lo que va a cantar. Se levanta con la plantilla Cadentrail, que trae los pesos dentro de la imagen y publica una API REST en el puerto 8000 sin autenticación.
El modelo de objetos es sencillo: un proyecto contiene los assets; dentro se encolan trabajos; cada trabajo produce una o varias tomas.
| Llamada | Para qué |
|---|---|
POST /api/projects |
crear el proyecto (name, tempo) |
POST /api/jobs |
encolar una generación |
GET /api/jobs/{id} |
seguirla (state, progress, stage) |
GET /api/projects/{id}/assets |
listar las tomas producidas |
GET /api/assets/{id}/audio |
bajar el audio de una toma |
El ciclo completo, en Python estándar:
import json, time, urllib.request

BASE = "https://<id-del-pod>-8000.proxy.runpod.net"    # cambia en cada arranque
CABECERAS = {"Content-Type": "application/json", "User-Agent": "Mozilla/5.0"}

def pide(metodo, ruta, cuerpo=None):
    datos = json.dumps(cuerpo).encode() if cuerpo is not None else None
    r = urllib.request.Request(BASE + ruta, data=datos, headers=CABECERAS, method=metodo)
    with urllib.request.urlopen(r, timeout=180) as resp:
        return json.loads(resp.read() or b"null")

# 1 · proyecto: el contenedor de tomas y partituras
proyecto = pide("POST", "/api/projects", {"name": "mi-cancion", "tempo": 78})

# 2 · trabajo de generación
trabajo = pide("POST", "/api/jobs", {
    "projectId": proyecto["id"],
    "kind": "generate",
    "candidates": 2,                        # dos tomas: se elige con el oído
    "generation": {
        "style": "cinematic ballad, female vocal, 78 BPM, warm strings, spanish guitar",
        "lyrics": letra_en_ingles,           # con etiquetas [verse] [chorus] [bridge]…
        "role": "female",
        "cot": "full",
        "odeSteps": 32,
    },
})

# 3 · seguirlo por `state` (ver el aviso de abajo)
while True:
    j = pide("GET", f"/api/jobs/{trabajo['id']}")
    if j.get("state") in {"Complete", "Failed", "Cancelled", "Error"}:
        break
    time.sleep(5)

# 4 · las tomas de ESTE trabajo (no las de intentos anteriores)
assets = pide("GET", f"/api/projects/{proyecto['id']}/assets")
tomas = sorted(
    (a for a in assets
     if a.get("origin") != "master"
     and (a.get("lineage") or {}).get("jobId") == trabajo["id"]),
    key=lambda a: (a["lineage"] or {}).get("candidateIndex") or 0,
)
El campo que manda es
state, nostatus. Un trabajo puede publicarstatus: "queued"durante toda la generación mientras avanza porstate; quien espere un valor enstatusse queda esperando para siempre, con la GPU facturando. Los estados finales son los cuatro de arriba:Complete,Failed,CancelledyError. Y ojo:Complete, nocompleted.
Los parámetros que de verdad cambian el resultado:
| Parámetro | Qué hace | Rango útil |
|---|---|---|
style |
la descripción sonora: género, instrumentación, BPM, tipo de voz | texto libre, con BPM explícito |
lyrics |
la letra, con etiquetas de sección | inglés o chino |
role |
quién canta | female, male, duet, auto |
candidates |
cuántas tomas por encargo | 1, 2, 4 u 8 |
odeSteps |
pasos del integrador (calidad/tiempo) | 32 es el equilibrio; 48+ encarece |
cot |
cadena de pensamiento musical (estructura antes de cantar) | full, melody, off |
seed |
repetibilidad | entero, o vacío para variar |
Bajar el audio sin corromperlo. El endpoint devuelve PCM crudo (no un MP3, aunque se haya pedido MP3 al encolar) y puede cerrar la conexión "limpiamente" con el fichero a medias: sin error, sin aviso, con un fichero de un sexto de su tamaño. La única defensa razonable es bajar por rangos y comprobar el tamaño contra el que declara el servidor:
def bajar_verificado(url, destino, trozo=4 << 20):
    """Rangos + verificación. El fichero definitivo sólo aparece si está entero."""
    total = tamaño_declarado(url)          # Range: bytes=0-0 → Content-Range
    tmp = destino + ".parcial"
    with open(tmp, "wb") as f:
        for inicio in range(0, total, trozo):
            fin = min(inicio + trozo, total) - 1
            datos = pedir_rango(url, inicio, fin)      # comprueba Content-Range
            if len(datos) != fin - inicio + 1:
                raise RuntimeError(f"tramo incompleto en {inicio}")
            f.write(datos)
    if os.path.getsize(tmp) != total:
        raise RuntimeError("el tamaño final no coincide")
    os.replace(tmp, destino)               # sólo ahora existe con su nombre bueno
La partitura (ABC). YuE2 no improvisa: antes de cantar escribe la partitura en formato ABC, con las voces separadas (la cantada y el acompañamiento) y las secciones marcadas. Se lee en segundos y ahorra discusiones: dice en qué segundo entra cada sección y en qué segundo empieza la voz. Si hay que decidir dónde cortar, dónde poner un fundido o cuánto dura la intro, ese fichero lo responde sin escuchar la canción entera.
#Paso 2 · El retrato y el encuadre
Todo el vídeo sale de una sola imagen. No hay memoria entre trozos más allá del último fotograma del anterior, así que la identidad se sostiene —o se pierde— en esa entrada.
| Requisito | Por qué |
|---|---|
| Cara de frente, mirando a cámara | el modelo tiene que ver la boca y los ojos |
| Luz uniforme, sin sombras duras | las sombras se reinterpretan y derivan |
| Cuadrada, 640×640 o mayor | el encuadre de salida se recorta a partir de aquí |
| Fondo sencillo y estable | fondos con textura son los primeros que se deforman |
| Sin texto ni marcas de agua | el modelo las intenta "leer" y acaban animándose |
El encuadre de salida se fija en el grafo, y conviene entender las tres cifras:
aspect_ratio:1:1 (Square)para redes,9:16 (Portrait)para móvil. Cambia el encuadre, no la identidad.megapixels: resolución por trozo. 0,6 MP (800×800) es un buen equilibrio entre detalle y coste; subir a 1 MP cuadruplica el tiempo por trozo.multiple: las dimensiones se redondean a múltiplos de 32; si no, el VAE falla.
Y un parámetro que no se toca a la ligera: 24 fps. El modelo está entrenado a esa cadencia y el audio se pega después, así que cambiarla sólo añade trabajo de conversión y riesgo de desincronía.
#Paso 3 · El pod de ComfyUI
La plantilla del avatar levanta ComfyUI con los modelos dentro. Se crea desde la terminal:
runpodctl pod create \
  --template-id <id-de-la-plantilla> \
  --gpu-id "NVIDIA A40" --cloud-type SECURE \
  --name avatar \
  --container-disk-in-gb 50 \
  --volume-in-gb 80 --volume-mount-path /workspace \
  --ports "8188/http,22/tcp" \
  --wait
--portssustituye la lista de la plantilla, no la amplía. Si sólo se declara el 8188, el pod se queda sin SSH y sin poder sacar nada de dentro. Hay que repetir todos los puertos que hagan falta en cada creación.
El primer arranque descarga unos 43 GB de modelos y tarda un buen rato. A partir de ahí, ese pod vale para todas las canciones: parado (stop) conserva el disco y los modelos, y volver a arrancarlo es cuestión de minutos. Borrarlo obliga a descargarlo todo otra vez.
La API de ComfyUI es pequeña; con seis rutas se hace todo:
| Ruta | Para qué |
|---|---|
GET /system_stats |
saber si el servidor ya está listo |
POST /upload/image |
meter el audio y el retrato en input/ |
POST /prompt |
encolar un grafo en formato API → devuelve prompt_id |
GET /history/{prompt_id} |
saber si terminó y qué produjo |
GET /queue |
ver qué corre y qué espera |
GET /view?filename=… |
descargar un fichero de salida |
Un cliente mínimo, sin dependencias raras:
import json, requests

class Comfy:
    def __init__(self, base): self.base = base.rstrip("/")

    def subir(self, ruta):
        with open(ruta, "rb") as f:
            r = requests.post(f"{self.base}/upload/image",
                              files={"image": (ruta.split("/")[-1], f)},
                              data={"overwrite": "true", "type": "input"},
                              timeout=600)
        r.raise_for_status(); return r.json()

    def encolar(self, grafo):
        r = requests.post(f"{self.base}/prompt", json={"prompt": grafo}, timeout=120)
        if r.status_code != 200:
            raise RuntimeError(f"grafo rechazado ({r.status_code}): {r.text[:2000]}")
        return r.json()["prompt_id"]

    def esperar(self, pid, limite=7200):
        t0 = time.time()
        while time.time() - t0 < limite:
            h = requests.get(f"{self.base}/history/{pid}", timeout=60).json()
            if pid in h:
                estado = (h[pid].get("status") or {}).get("status_str")
                if estado == "error":
                    raise RuntimeError("el grafo falló: " + json.dumps(h[pid]["status"])[:2000])
                return h[pid]
            time.sleep(5)
raise TimeoutError(pid)#Paso 4 · Del workflow del editor al formato API
ComfyUI tiene dos representaciones del mismo workflow, y confundirlas es la primera piedra del camino:
| Formato | Quién lo usa | Qué contiene |
|---|---|---|
| UI | el editor y los .json que exporta |
nodes, links, posiciones, subgrafos, nodos de interfaz |
| API | POST /prompt |
{"12": {"class_type": "…", "inputs": {…}}} |
El editor tiene un botón «Export (API)», pero con subgrafos anidados y combos dinámicos falla o pierde información. Convertirlo por código son cuatro reglas:
- Enlaces: en el formato API una entrada conectada es un par
[id_del_nodo_origen, ranura]. Loslinksdel editor vienen en dos formatos según estén en el grafo padre o en un subgrafo (listas y diccionarios); hay que normalizarlos. - Subgrafos: se aplanan prefijando los ids internos (
<id_instancia>:<id_interno>). Los nodos de borde son la clave: un enlace con origen-10entra desde fuera y uno con destino-20sale hacia fuera. - Nodos de interfaz (
Note,MarkdownNote, títulos…) no existen en el servidor: se descartan comparando el tipo contra elobject_infodel propio servidor. - Widgets: los valores de los campos se leen por nombre (
widgets_values_named), nunca por posición: el orden cambia entre versiones y un desfase silencioso produce vídeos malos, no errores.
def aplanar(ui, object_info):
    api = {}
    for nodo in ui["nodes"]:
        if nodo["type"] not in object_info:        # nodo de interfaz: no se ejecuta
            continue
        entradas = {}
        for e in nodo.get("inputs", []):
            if e.get("link") is not None:
                origen, ranura, _, _ = enlaces[e["link"]]
                entradas[e["name"]] = [str(origen), ranura]      # forma del enlace en API
        for nombre in nombres_de_widget(object_info, nodo["type"]):
            if nombre in nodo.get("widgets_values_named", {}):
                entradas[nombre] = nodo["widgets_values_named"][nombre]
        api[str(nodo["id"])] = {"class_type": nodo["type"], "inputs": entradas}
    return api
Los combos dinámicos (v3). Algunos nodos declaran una entrada
COMFY_DYNAMICCOMBO_V3cuyos subcampos aparecen como claves con punto (resize_type.width). El servidor espera el discriminador plano ("resize_type": "scale dimensions") junto a esas claves planas; si se anidan en un diccionario, el nodo recibe un argumento que no conoce; si se omiten, pierde el que sí conoce. Se resuelven solas cuando el discriminador viaja.
Y antes de encolar, una validación de una línea que ahorra una tirada entera:
rotos = [(nid, k, v) for nid, n in api.items()
         for k, v in n["inputs"].items()
         if isinstance(v, list) and len(v) == 2 and str(v[0]) not in api]
assert not rotos, f"enlaces a nodos que no existen: {rotos[:5]}"#Paso 5 · Dar forma al grafo para vídeo largo
La plantilla trae un workflow pensado para clips de pocos segundos. Para una canción hay que añadirle el juego de nodos longform, que es lo que convierte un generador de clips en una cadena de montaje:
| Nodo | Qué hace |
|---|---|
LTXLongformSplit |
parte el audio en trozos (por pausas, no por reloj) |
LTXLongformStartFrame |
da al trozo N el último fotograma del N-1 |
LTXLongformWrite |
escribe cada trozo en disco |
LTXLongformAudioName |
deriva el nombre de la sesión |
El troceado. El nodo parte por pausas (cut_mode: pause) buscando cortes naturales,
con un objetivo de 8 s por trozo, mínimo 3 y máximo 12. Eso importa: cortar en mitad de una
palabra produce un salto visible en la boca, y cortar en una pausa lo esconde.
El encadenado continuo, y su condición. Por defecto la plantilla ancla el primer y el
último fotograma al mismo retrato, así que cada trozo empieza y acaba en la misma pose: el
resultado parece un bucle cada ocho segundos. Para encadenar de verdad hay que quitar la guía
de fin (frame_idx = -1) y dejar sólo la de inicio, redirigiendo lo que la leía:
# 1 · el trozo N arranca del último fotograma del N-1, con reenganche periódico al retrato
api["900"] = {"class_type": "LTXLongformStartFrame",
              "inputs": {"portrait": ["39", 0], "chunk_index": ["260", 0],
                         "reanchor_every": 6}}
api["251:213"]["inputs"]["input"] = ["900", 0]

# 2 · fuera la guía de fin: todo lo que la leía pasa a leer la de inicio
for nodo in api.values():
    for k, v in list(nodo["inputs"].items()):
        if isinstance(v, list) and len(v) == 2 and v[0] == "251:204":
            nodo["inputs"][k] = ["251:206", v[1]]
del api["251:204"]
El reenganche. Encadenar del fotograma anterior es lo que da continuidad, pero también lo
que acumula deriva: cada trozo hereda los errores del anterior. Cada N trozos se vuelve a
anclar al retrato original (reanchor_every) para que la cara no se vaya. Con 6 el resultado
aguanta cuatro minutos y medio, con deriva visible al final: es el compromiso entre continuidad
y fidelidad, y no hay ajuste que lo elimine del todo.
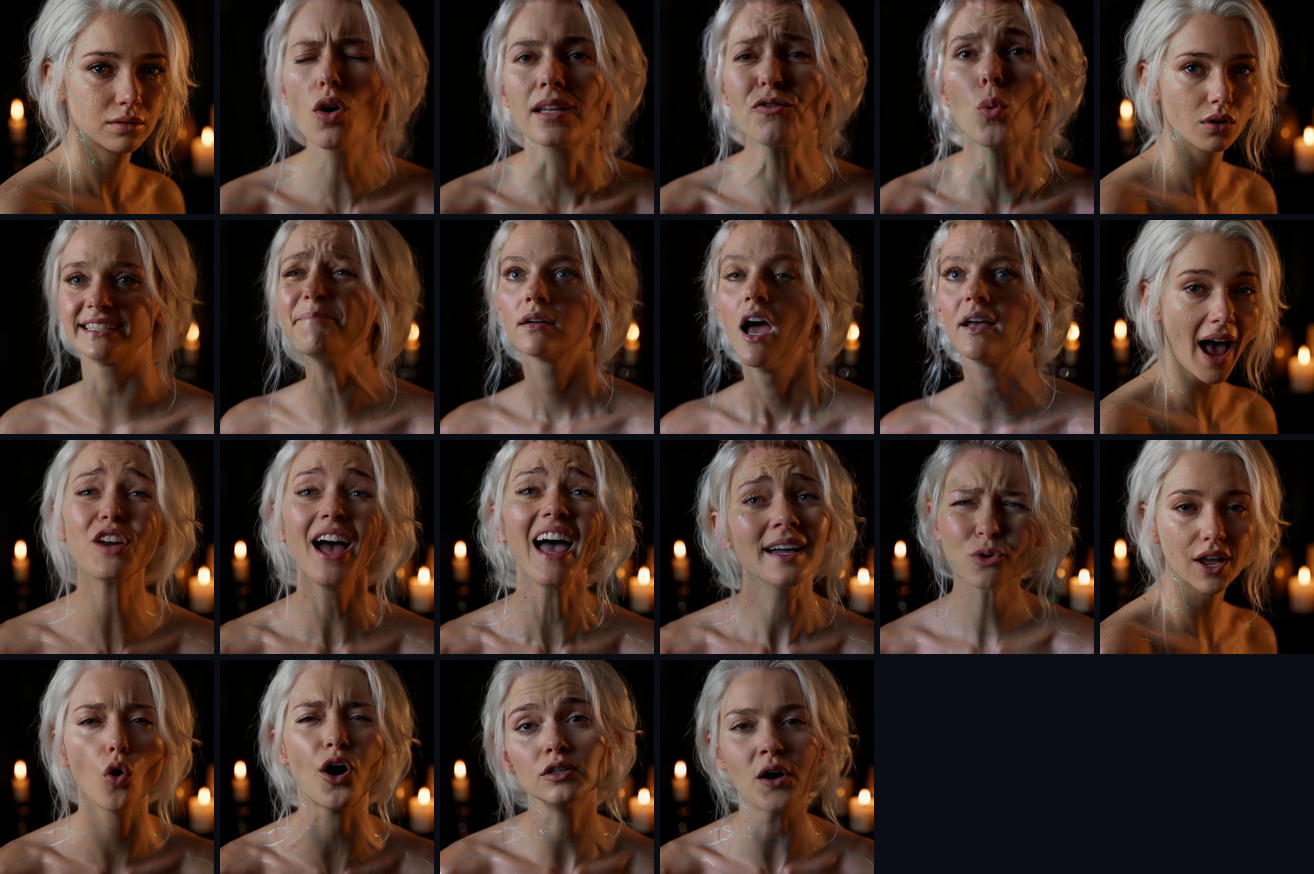
El nombre de la sesión, escrito, no derivado. El nodo que deduce el nombre de la sesión a partir del prompt tiene un problema de fondo: ComfyUI cachea la salida de los nodos, y sus entradas no cambian entre canciones. En la segunda canción sigue devolviendo el nombre de la primera: el nodo que escribe guarda los trozos en la carpeta vieja mientras el encadenado busca los anclajes en la nueva, cada trozo vuelve a arrancar del retrato, y el log dice «escrito» con toda la razón. La regla general vale para cualquier pipeline:
No derives un dato que el motor cachea; escríbelo. Un valor derivado más una caché son dos verdades, y la equivocada es la que no ves.
sesion = os.path.splitext(os.path.basename(audio))[0]
g["262"]["inputs"]["session"] = sesion          # texto literal
g["262"]["inputs"]["filename"] = sesion + ".mp4"#Paso 6 · Ejecutar en orden, y poder reanudar
Los trozos no son independientes: el N necesita el último fotograma del N-1. Se encolan de uno en uno, esperando a que cada uno termine. No hay paralelismo útil aquí.
Dos cosas hacen que esto sea barato de repetir:
skip_existingen el nodo de escritura: un trozo ya escrito se salta en milisegundos, así que reanudar tras un fallo no vuelve a pagar lo ya hecho./interrupt: corta el trabajo en curso sin matar el pod ni perder lo anterior.
for idx in range(desde, hasta + 1):
    g = copy.deepcopy(grafo_base)
    g["259"]["inputs"]["audio"] = audio          # LoadAudio
    g["39"]["inputs"]["image"] = retrato         # LoadImage
    g["260"]["inputs"]["value"] = idx            # chunk_index
    g["262"]["inputs"]["session"] = sesion
    g["262"]["inputs"]["filename"] = sesion + ".mp4"

    t0 = time.time()
    pid = comfy.encolar(g)
    comfy.esperar(pid)                           # aquí se paga la GPU: no paralelizar
    print(f"trozo {idx}: {time.time() - t0:.0f}s")
El último trozo (chunk_index == total - 1) es especial: es el que cose el vídeo entero y le
pega el audio original. Por eso el audio tiene que ser la pista de entrada del grafo, no una
reconstrucción del VAE.
Cuántos trozos hay lo decide el troceador, no tú. Se sabe mirando el log del primer trozo o
contando las pausas del audio; a partir de ahí, el rango es 0..total-1. Y con eso ya se puede
estimar el coste real: total × segundos_por_trozo / 3600 × precio_hora.
#Paso 7 · Traer y verificar
El vídeo se descarga por /view, igual que cualquier salida de ComfyUI. Y se verifica antes
de tocar nada:
| Comprobación | Cómo |
|---|---|
| Duración | ffprobe -show_entries format=duration ≈ duración de la canción |
| Fotogramas | ffprobe -select_streams v:0 -show_entries stream=nb_frames |
| Resolución | stream=width,height |
| Pista de audio | -select_streams a:0 -show_entries stream=codec_name,channels |
| Tamaño | que no sea un múltiplo sospechosamente redondo ni un fichero de 0 s |
Un vídeo truncado se detecta por la duración, no por el tamaño: es el error más común al bajar ficheros grandes desde un pod.
#Paso 8 · Montaje y acabado con ffmpeg
El montaje final se hace en local, sin GPU, en una sola pasada: una única recompresión para
todo el vídeo y el audio copiado (-c:a copy), de forma que la sincronía sea exacta por
construcción: no hay dos pistas que puedan desviarse porque sólo hay una.
La estructura del filtro es siempre la misma, aunque los números cambien:
ffmpeg -i original.mp4 -loop 1 -i retrato.png -filter_complex "
  # 1 · placa: el retrato en reposo, con respiración y entrada desde negro
  [1:v]scale=800:800,
       zoompan=z='1.0+0.045*on/176+0.004*sin(on*0.0654)':d=1:s=800x800:fps=24,
       fade=t=in:st=0:d=0.9[placa];

  # 2 · disolvencia al vídeo real justo cuando entra la voz
  [0:v][placa]xfade=transition=fade:duration=0.6:offset=6.75[inicio];

  # 3 · cierre: último fotograma congelado, acercamiento mínimo, fundido a negro
  ... fade=t=out:st=...:d=1.3[fin]
" -map "[fin]" -map 0:a -c:a copy -c:v libx264 -crf 18 salida.mp4
Las tres piezas del truco:
zoompancon un término lineal (on) para el acercamiento y un seno para la respiración: sin el seno, un retrato fijo se ve inmediatamente como una foto.xfadeconoffsetcalculado a partir del segundo en que entra la voz menos la duración de la disolvencia: el corte cae exactamente donde empieza el canto.fade=t=outsobre el último fotograma congelado (tpad/loop), no sobre el vídeo: así no se pierde ningún gesto.
Y la verificación, que es la mitad del trabajo:
# la duración y los fotogramas tienen que cuadrar con lo previsto
ffprobe -v error -show_entries format=duration -of csv=p=0 salida.mp4

# el audio tiene que ser EL MISMO byte a byte antes y después del montaje
ffmpeg -v error -i original.mp4 -map 0:a -c copy -f md5 -
ffmpeg -v error -i salida.mp4    -map 0:a -c copy -f md5 -

# la imagen sólo debe haber perdido lo que impone la recompresión
ffmpeg -i original.mp4 -i salida.mp4 -lavfi "[0:v][1:v]psnr" -f null -
Si el MD5 del audio no coincide, el montaje ha tocado lo que no debía. En este proyecto coincidió
(076c470f… en los dos), y el PSNR de la parte no modificada se quedó por encima de 44 dB en el
peor fotograma y 50 dB de mediana.
#Paso 9 · Cerrar la cuenta
runpodctl pod stop <id>       # deja de cobrar GPU; conserva disco y modelos
runpodctl pod delete <id>     # se acabó; el disco de contenedor NO sobrevive
runpodctl pod list            # ¿queda algo encendido?
runpodctl user                # gasto por hora y saldo final
Antes de borrar, la lista de comprobación: ¿está el resultado descargado y verificado? ¿está aprobado? ¿está guardado el original intacto? Borrar es irreversible; parar es gratis. Cuando hay duda, se para.
#Escala y coste
Los números de este proyecto, para que sirvan de regla de tres:
| Dato | Valor |
|---|---|
| Duración del vídeo | 269 s (4:29) |
| Trozos | 23 (de 3 a 12 s) |
| Resolución por trozo | 0,6 MP (800×800), 24 fps |
| GPU | A40 48 GB, Secure Cloud, 0,59 $/h |
| Coste de la música | un pod aparte, arranque + generación + descarga |
| Coste total | 4,92 $ (≈ 8,3 h de A40 equivalentes) |
| Coste por minuto de vídeo | ≈ 1,1 $/min |
| Disco de un pod parado | ≈ 0,056 $/h (≈ 40 $/mes si se olvida) |
La fórmula para planificar lo propio:
coste ≈ (trozos × segundos_por_trozo + descarga_de_modelos) / 3600 × precio_horaDos avisos que ahorran dinero: la primera tirada es la más cara (incluye los 43 GB de modelos y los ajustes que salen mal) y la GPU encendida sin trabajar es el gasto más tonto que existe. Cualquier proceso que corra de noche tiene que poder parar el pod solo, y sobrevivir a que se cierre la terminal desde la que se lanzó.
#Qué promptear y qué no
En un modelo de avatar guiado por audio, el prompt no describe la escena: describe el movimiento. La imagen ya trae la escena.
#La anatomía de un buen prompt positivo
| Parte | Qué poner | Ejemplo |
|---|---|---|
| Sujeción a la imagen | que la primera imagen manda | «Use the provided start image as the first frame» |
| Acción | lo que hace, atado al audio | «sings directly to camera, lips matching the vocal exactly» |
| Micro-movimiento | lo que hace humano | «subtle eyebrow and jaw movement, occasional blinking» |
| Estabilidad | que el encuadre no cambie | «framing, lighting and background stay exactly as in the start image» |
| Exclusiones | lo que no debe aparecer | «no text, no captions, no black frames, no scene change» |
#Lo que sí y lo que no
| ✅ Sí | ❌ No |
|---|---|
| Describir movimiento y dicción | Describir el aspecto: pelo, ropa, joyas |
| Repetir que la cámara está fija | Pedir movimientos de cámara (zoom, dolly, paneo) |
| Un solo sujeto, un solo plano | Cambios de escena o de plano |
| Mencionar el audio como fuente del gesto | Inventar diálogo o texto en pantalla |
| Ser breve y concreto | Listas de adjetivos poéticos: el modelo los promedia |
El aspecto se deja fuera a propósito. Si el prompt dice «pelo rubio largo», el modelo tiene que reconciliar el texto con la imagen en cada trozo; cuando hay una diferencia mínima, la resuelve cambiando la cara. Describir sólo lo que se mueve es lo que mantiene la identidad.
Un prompt que funciona, completo:
Use the provided start image as the first frame. The person sings directly to camera,
lip movements matching the provided vocal audio exactly. Natural facial expression,
subtle eyebrow and jaw movement, occasional blinking, small head movements while
singing. The framing, lighting and background stay exactly as in the start image.
Static camera, steady medium close-up. No text, no captions, no black frames,
no scene change.#El prompt negativo, y su trampa
El negativo sirve para las averías típicas: identidad que se rompe, boca deformada, manos de más, texto inventado.
distorted face, deformed facial features, warped mouth, extra limbs, extra fingers,
text, captions, subtitles, watermark, cartoon, 3d render, video game,
camera shake, scene change, cut to another shot, black frames
La trampa: no le prohíbas estarse quieto. Frases como
static image,still frame,frozen,no motion,motionless subjectomouth closed while speakingparecen inocentes y son una bomba de relojería: en cuanto el audio tiene un tramo instrumental, el modelo no puede quedarse quieto ni cerrar la boca, así que se inventa la articulación y «canta» los violines. Es el defecto que se ve abajo. Si el vídeo tiene intro instrumental (o un silencio), esas prohibiciones se quitan o se condicionan por trozo.
Cuatro reglas que salen de todo esto:
- Describe el movimiento, no el aspecto. La identidad viene de la foto.
- No pidas cámara. Cada movimiento de cámara es una oportunidad de que el fondo derive.
- Cuida el negativo. Un negativo genérico copiado de una plantilla puede estar peleándose con tu caso concreto.
- Cambia una cosa por vez. Prompt, semilla, resolución o negativo: de uno en uno, o no sabrás qué arregló qué.
#Dos retoques al final del pipeline (y por qué)
El vídeo que sale del modelo es correcto y, aun así, casi nunca está listo para publicar. Dos retoques baratos lo arreglan, y ambos se hacen en la misma pasada de ffmpeg:
El principio. Si hay intro instrumental, el avatar articula desde el primer fotograma, porque no se le ha permitido estarse quieto (ver la trampa del negativo). La solución no es recortar —te llevarías la música—, sino tapar la imagen: el retrato en reposo, con una respiración sutil y una entrada desde negro, y una disolvencia al vídeo real exactamente en el segundo en que entra la voz. Se elige ese segundo mirando el gráfico de energía y, sobre todo, comprobando que en ese fotograma la boca está cerrada: si la disolvencia pilla al modelo a medio gesto, se nota muchísimo.
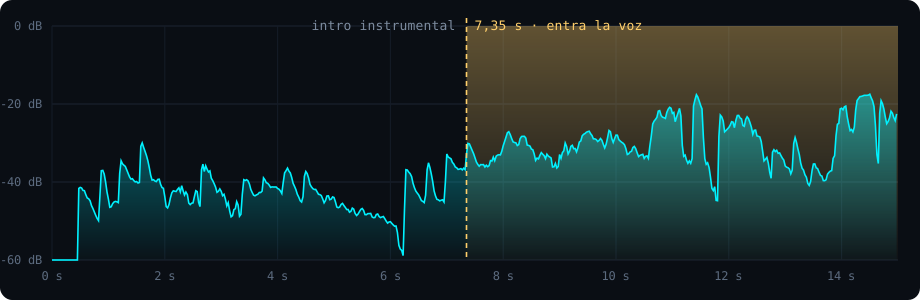
Así se ve la diferencia, con el mismo audio en los dos lados:
El final. El render corta en seco, en mitad de un gesto. Se congela el último fotograma dos segundos y medio, se le da un acercamiento mínimo (1 %) y se funde a negro en el último segundo y medio. El audio no se toca: la canción ya ha terminado y ese silencio es parte del cierre.
Son dos ajustes de una línea cada uno y son los que separan «una demo técnica» de «un vídeo que se puede enseñar». Merece la pena mirar siempre el primer y el último fotograma de un render largo: son los dos sitios donde el modelo se delata.
#Herramientas y referencias
- LTX-2.5 (Lightricks): pesos y tarjetas en huggingface.co/Lightricks/LTX-2.5. Los ficheros que usa el grafo son el transformador de 22B cuantizado a int8, dos VAE (vídeo y audio) y el codificador de texto.
- Gemma 4 (Comfy-Org/gemma-4): el codificador de texto y el pequeño modelo que reescribe el prompt antes de que lo vea el generador.
- ComfyUI (github.com/comfyanonymous/ComfyUI): el motor que ejecuta el grafo; su API está documentada en el propio repositorio y se explora sola con
GET /object_info. - RunPod (docs.runpod.io): pods, plantillas de la comunidad y
runpodctl. El catálogo se busca desde la terminal conrunpodctl template search. - ffmpeg (ffmpeg.org): montaje, filtros (
zoompan,xfade,fade) y verificación (psnr).
Y una recomendación de método, que vale más que cualquier parámetro: mide antes de gastar, verifica antes de borrar y no derives lo que puedas escribir. Casi todos los sustos de este trabajo vienen de ahí, no del modelo.