---
titulo: "Chaplin 2026: El Gran Dictador en la era digital"
subtitulo: "De 1940 a la inteligencia artificial: cómo clonar la voz de Charles Chaplin en español, modernizar su discurso mítico con ElevenLabs y sincronizar sus labios neuronalmente mediante difusión latente con LatentSync."
resumen: "El pipeline completo de ingeniería audiovisual: clonación de voz con ElevenLabs, edición rítmica con ffmpeg, extracción de landmarks canónicos, condicionamiento acústico con Whisper Tiny y difusión latente en GPU NVIDIA A40 gobernada por terminal. Con explicaciones matemáticas, scripts de ensamblado y comparativas A/B."
fecha: 2026-10-27
orden: 3
etiquetas: [ElevenLabs, LatentSync, RunPod, ffmpeg, Whisper, Difusión Latente, Python]
hero: /assets/labs/chaplin-2026/portada.jpg
video: /assets/labs/chaplin-2026/video.mp4
poster: /assets/labs/chaplin-2026/poster.jpg
coste: "≈ 0,55 $ USD"
duracion: "35 minutos de GPU"
estado: publicado
---
## Qué se consigue (y qué demostramos)
El discurso final de *El Gran Dictador* (1940) es una de las cumbres éticas e interpretativas del siglo XX. Pero si hoy le damos una voz clonada en castellano con un texto adaptado al mundo de los algoritmos y la desinformación, enfrentamos un choque inmediato: **la disonancia labial**. Un espectador percibe un desfase de apenas tres fotogramas como artificial o grotesco.
Aquí demostramos la solución completa de ingeniería: **162,07 segundos** donde Charles Chaplin pronuncia en perfecto español su discurso modernizado, con sincronía labial hiperrealista fotograma a fotograma, respiración orgánica y preservación milimétrica de su rostro histórico.
| | |
|---|---|
| **Salida Master** | **640×360, 25 fps**, H.264 + AAC Estéreo 44.1 kHz · **162,07 s** (4.051 fotogramas) |
| **Audio Master** | Pista continua en alta definición (ElevenLabs HD + sonido de ambiente y ovación original) |
| **Entrada** | Metraje restaurado de 1940 (.mp4) y audio clonado de ElevenLabs v4 (.mp3) |
| **GPU** | 1 pod de RunPod: **NVIDIA A40 48 GB VRAM** (Secure Cloud, 0,59 $/h) |
| **Coste medido** | **≈ 0,55 $ USD** por el pipeline completo (POC previo + discurso íntegro) |
| **Tiempo de sesión** | **35 minutos** de inferencia de difusión latente en la GPU |
| **YouTube** | [youtu.be/YIcMqP0oxz0](https://youtu.be/YIcMqP0oxz0) (Master oficial en Color) |
| **Entregables** | Master COLOR de referencia y Master BLANCO Y NEGRO cinematográfico de 1940 |
Versión Master Color (Referencia)
Versión Master Blanco y Negro (1940)
---
## La ficha técnica
### Las piezas de la cadena
Ningún modelo único resuelve este problema de extremo a extremo. El trabajo se distribuye en una cadena de responsabilidades claras:
| Pieza | Qué resuelve | Cómo se controla | Coste |
|---|---|---|---|
| **ElevenLabs** | Clona el timbre histórico de Chaplin en español | API / Interfaz Studio | Saldo máster |
| **LatentSync 1.6** (ByteDance) | Sincroniza labios mediante difusión en espacio latente | Scripts Python / PyTorch | Gratis (Open Source) |
| **Whisper Tiny** (OpenAI) | Extrae tokens acústicos y fonemas de la voz | Torch Hub / HuggingFace | Gratis (MIT) |
| **InsightFace (Buffalo_L)** | Detección facial, 2D landmarks y alineación afín | ONNX Runtime CUDA | Gratis |
| **RunPod (NVIDIA A40)** | Alquiler de GPU con 48 GB de VRAM en Suecia | `runpodctl` (CLI) | 0,59 $/h |
| **ffmpeg** | Montaje, corrección rítmica y masterizado estéreo | Terminal Bash | Gratis |
---
## La ciencia por dentro: cómo funciona la difusión latente de labios
Para comprender por qué **LatentSync** supera drásticamente a métodos clásicos como *Wav2Lip* (que generaban bocas borrosas de 96×96 píxeles), hay que entender el flujo de difusión condicionada:
```mermaid
flowchart TD
Audio["Audio Español (16 kHz PCM)"] --> Whisper["Encoder Whisper Tiny"]
Whisper --> Embeddings["Embeddings Fonéticos (Tokens de Voz)"]
Video["Fotograma Original de Chaplin"] --> Retina["Detector Facial RetinaFace"]
Retina --> Landmarks["Landmarks y Alineación Afín"]
Landmarks --> Mascara["Máscara Inpainting (Boca/Barbilla)"]
Video --> VAE_Enc["Encoder VAE (Espacio Latente)"]
VAE_Enc --> LatenteOriginal["Latente Visual Comprimido"]
Ruido["Ruido Gaussiano"] --> UNet["UNet Denoising (20 timesteps)"]
Embeddings -.->|"Cross-Attention (Fonemas)"| UNet
LatenteOriginal -.->|"Self-Attention (Identidad y Piel)"| UNet
UNet --> LatenteLimpio["Boca Sincronizada en Latente"]
LatenteLimpio --> VAE_Dec["Decoder VAE"]
VAE_Dec --> Blend["Paste-back sobre Metraje Original"]
Blend --> Master["Fotograma Final 640x360"]
```
### 1. Geometría canónica y tracking de landmarks
El modelo no puede recibir la cabeza girando libremente en pantalla. En cada frame, **RetinaFace** localiza la cara y un modelo de 106 puntos clave (*landmarks*) calcula una transformación afín matemática que alinea horizontalmente los ojos de Chaplin. Sobre esa cara canónica, se aísla únicamente el tercio inferior (bajo la nariz hasta la barbilla), dejando intacto el sombrero, los ojos y el fondo.
### 2. El espacio latente del VAE
Trabajar directamente sobre millones de píxeles RGB produce artefactos de parpadeo (*flickering*). Un **Autoencoder Variacional (VAE)** comprime la imagen 8 veces en un espacio latente donde cada dimensión matemática codifica textura de piel, luces y estructura tridimensional.
### 3. El "oído" fonético: Whisper
En vez de ondas de audio crudas o mel-espectrogramas de volumen, se inyectan las representaciones acústicas de **Whisper**. Whisper comprende fonemas concretos:
- Fonemas **bilabiales** (/b/, /p/, /m/) donde los labios deben sellarse físicamente.
- Fonemas **dentales** (/d/, /t/) donde la lengua asoma tras los dientes.
- **Vocales abiertas** (/a/, /o/) con apertura mandibular pronunciada.
### 4. Coarticulación y ventanas de 16 frames
En el habla real, los labios ya se están redondeando antes de emitir un sonido. LatentSync procesa bloques deslizantes de **16 fotogramas** con capas de auto-atención temporal, asegurando transiciones continuas e inercia orgánica.
### 5. Denoising en 20 pasos
Partiendo de ruido aleatorio en la zona enmascarada, la red **UNet** retira el ruido en 20 iteraciones sucesivas guiada simultáneamente por la identidad de Chaplin (visual) y los fonemas de Whisper (acústica).
---
## La hoja de ruta paso a paso
### Paso 1: Edición métrica del pre-montaje
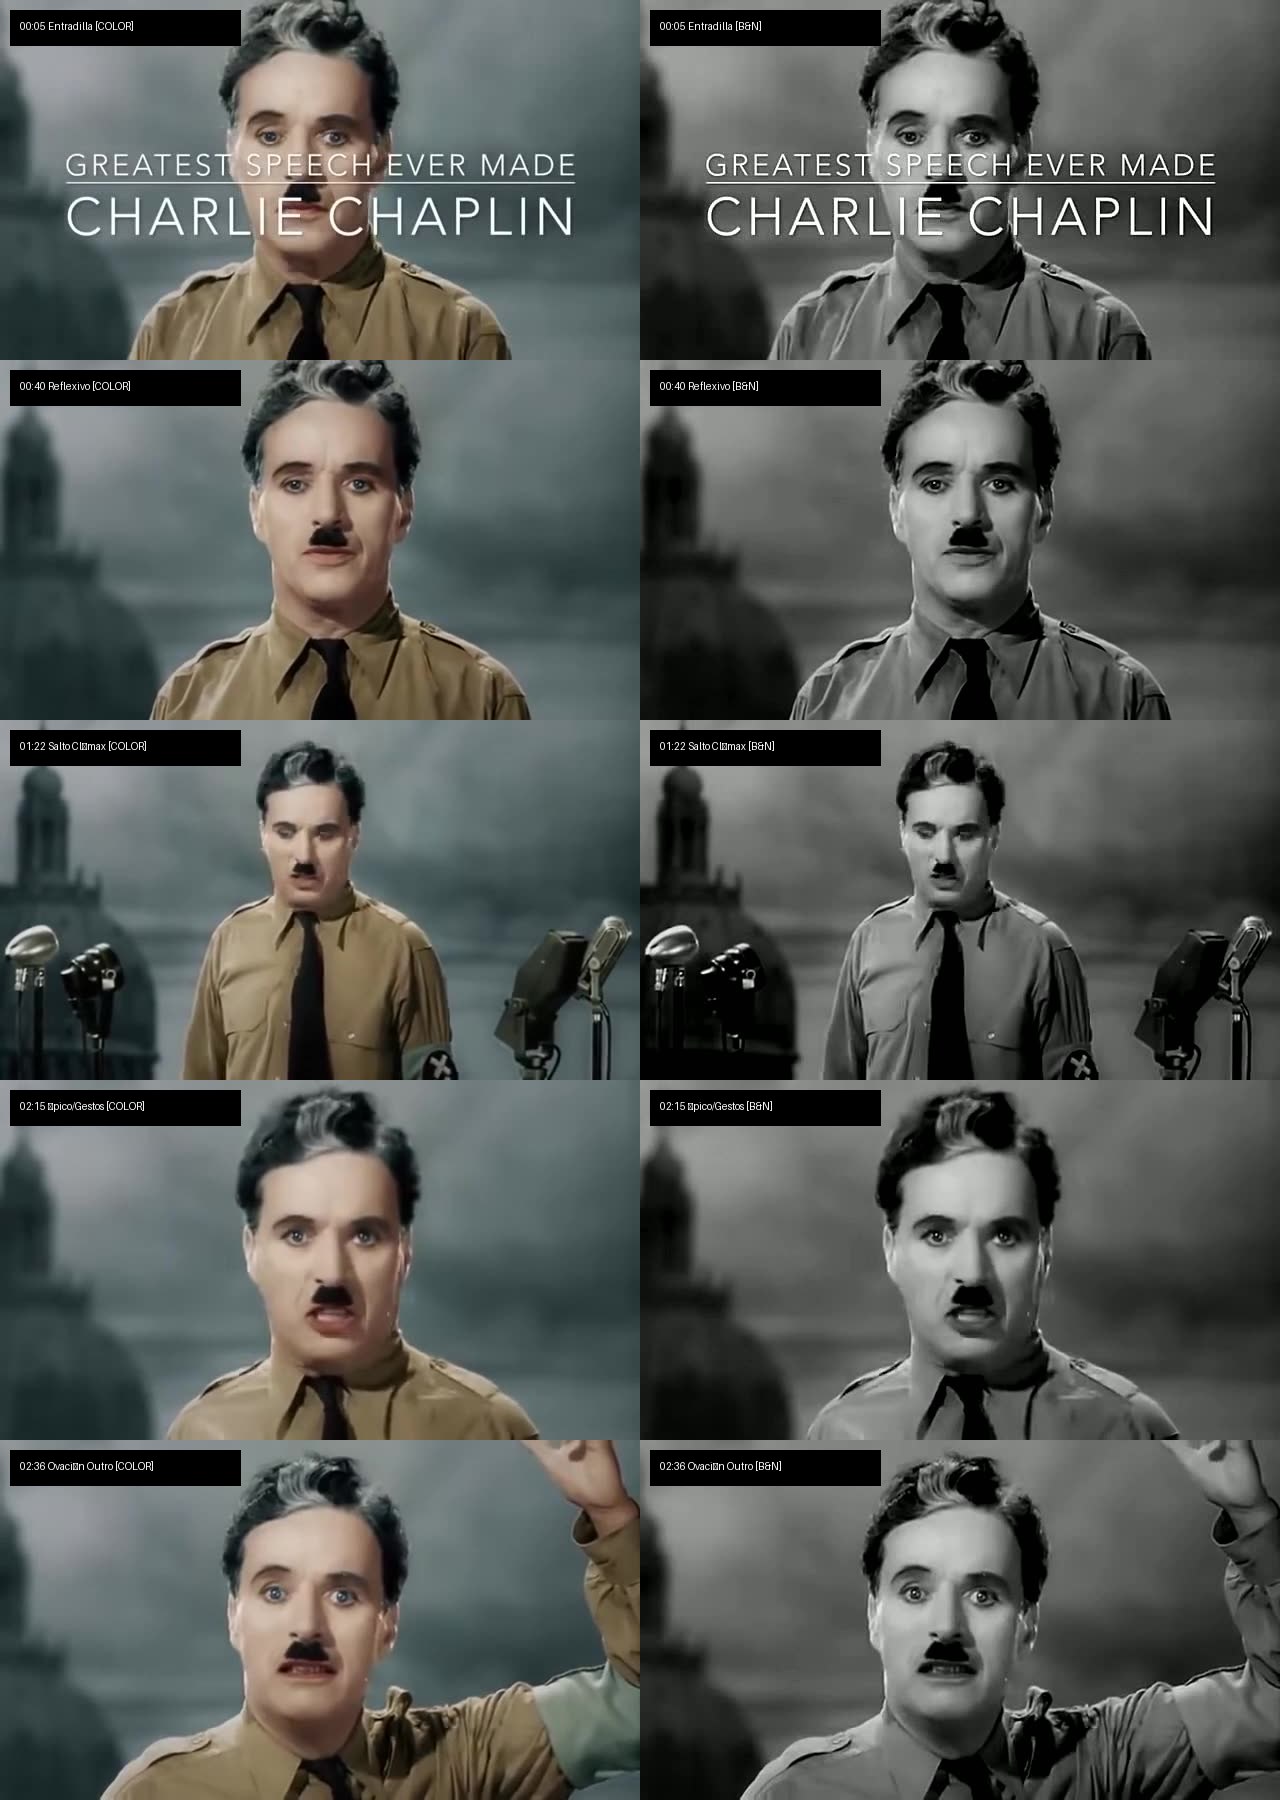
El audio modernizado dura **141,48 segundos**, mientras que el metraje original de Chaplin dura **229,44 segundos**. Un pegado directo 1:1 fracasa porque en el vídeo histórico Chaplin camina lentamente durante 11 segundos y su clímax teatral ocurre mucho más tarde.
Diseñamos una arquitectura dramática en 3 bloques:
1. **Entradilla (0.0s - 11.0s):** Chaplin camina hacia los micrófonos con el sonido de sala original.
2. **Discurso activo (11.0s - 152.48s):**
- Plano general/medio (11.0s - 80.0s del original).
- Corte al primer plano apasionado (138.44s - 210.92s del original).
3. **Outro (152.48s - 162.06s):** Saludo triunfal con la ovación y vítores de la multitud original.
```bash
# Extracción y ensamblado del pre-montaje con audio HD
python3 build_premontaje.py
```
---
### Paso 2: El ensayo en corto (POC de 15 segundos)
Antes de comprometer 35 minutos de GPU, aislamos un tramo de 15 segundos en el clímax emocional (a partir de 01:34) para validar la naturalidad del lip-sync:
Comparativa A/B: Original de 1940 (izquierda) vs LatentSync IA (derecha).
El resultado confirmó la perfecta articulación del castellano sobre el rostro de Chaplin.
---
### Paso 3: Inferencia neuronal completa en RunPod
Aislamos el metraje de discurso activo (11.0s a 152.48s = 141.48s) y preparamos las condiciones de contorno:
- Vídeo resampleado rígidamente a **25 fps** (`-r 25`).
- Audio resampleado a **16.000 Hz PCM mono** para Whisper.
```bash
# Lanzar la inferencia en la A40
python3 -m scripts.inference \
--unet_config_path configs/unet/stage2_512.yaml \
--inference_ckpt_path checkpoints/latentsync_unet.pt \
--inference_steps 20 \
--guidance_scale 1.5 \
--enable_deepcache \
--video_path /workspace/full_speech_video_25fps.mp4 \
--audio_path /workspace/full_speech_audio_16k.wav \
--video_out_path /workspace/output_full_speech_latentsync.mp4
```
- **Landmarks extraídos:** 3.538 fotogramas (5 minutos).
- **Difusión latente:** 222 bloques temporales de 16 fotogramas (31 minutos y 53 segundos a 8,6 s/bloque).
- **Reintegración facial:** 3.538 rostros fusionados a 25 fps (2 minutos y 21 segundos).
---
### Paso 4: Ensamblado del Master Final con Audio HD
LatentSync exporta un audio a 16 kHz mono. Para un acabado cinematográfico, descartamos esa pista y cosimos el vídeo sincronizado con la pista maestra de audio original estéreo a 44.1 kHz:
```python
# build_final_master.py (Fragmento clave)
# 1. Unir Video: Intro (11s) + Synced Speech (141.48s) + Outro (9.58s)
# 2. Muxar con Pista de Audio Continua HD (44.1 kHz Estéreo)
subprocess.run([
"ffmpeg", "-y",
"-i", full_video_joined,
"-i", master_audio_hd,
"-c:v", "copy",
"-c:a", "aac", "-b:a", "192k",
"-shortest",
final_color
], check=True)
```
---
## Lecciones aprendidas y reglas de oro
1. **La trampa de los FPS:** LatentSync asume estrictamente 25 fps (`video_fps: 25`). Si le envías metraje a 29 fps, se produce una deriva temporal acumulativa (*drift*) de 4 frames por segundo: el audio se adelanta y al minuto el desfase es catastrófico. **Regla:** Normalizar a 25 fps antes de la inferencia.
2. **No pasar tramos mudos por la red:** La entradilla de Chaplin caminando al atril no tiene voz. Pasarla por LatentSync hace que la red intente sincronizar los pasos con movimientos bucales erráticos. Conservar la entradilla y el outro limpios ahorra GPU y preserva la naturalidad.
3. **Preservar el audio estéreo original:** El audio de salida de los modelos de lip-sync está degradado a 16 kHz por las necesidades de Whisper. El ensamblado final debe usar siempre la pista original de ElevenLabs en alta fidelidad.
4. **Disciplina de gasto en RunPod:** Una vez descargado y verificado el archivo en local, el pod se destruye de inmediato (`runpodctl pod delete`). Mantener máquinas ociosas es una negligencia inadmisible.
---
## Comprobación y verificación técnica
Los dos masters finales cumplen las especificaciones de entrega de broadcast y plataformas web:
```json
{
"format": {
"filename": "chaplin_2026_master_color.mp4",
"duration": "162.075011",
"size": "12820551",
"bitrate": "632800"
},
"video": {
"codec": "h264 (High)",
"width": 640,
"height": 360,
"fps": "25/1"
},
"audio": {
"codec": "aac",
"sample_rate": "44100",
"channels": 2,
"bitrate": "192000"
}
}
```
Chaplin ha vuelto a hablar. Esta vez, en español, con voz viva y recordándonos que en la era de los algoritmos y la inteligencia artificial, **la humanidad sigue siendo lo primero**. 🎩✨